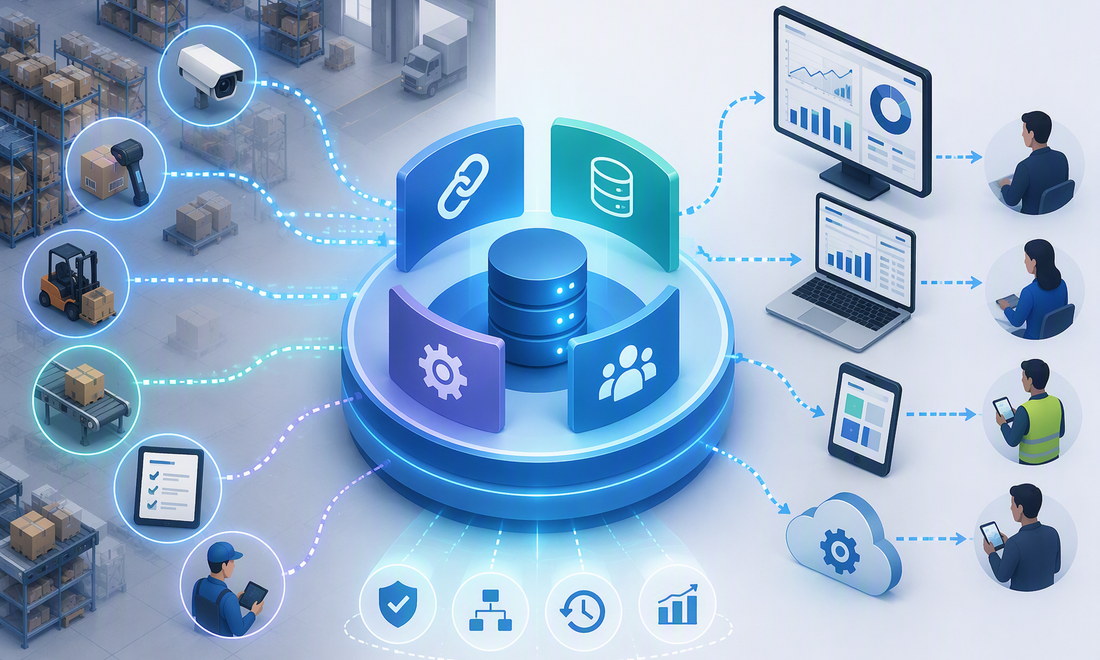
コラム | 物流データ基盤 シリーズ総まとめ | 2026年9月25日
物流データ基盤とは何か
—集めたデータを現場で使える状態にするための設計と運用
このページでわかること
・物流データ基盤が必要になるのは、どんな状態になったときか
・基盤が担う「連携・蓄積・加工・提供」という4つの役割
・データを比較できる状態にし、品質を保ち、使い続けるための設計
・シリーズ全9回の内容と、課題別にどの回を読めばよいか
倉庫のデータ収集を進めていくと、ある時期から状況が変わります。ハンディ端末の読み取り記録が溜まり、設備の稼働ログが残り、WMSには日々の出荷実績が積み上がっていく。「データがない」という状態は、確かに解消されています。
ところが、そこから分析がすぐに始まるとは限りません。「昨日の出荷が2時間遅れた原因は何か」という問いに答えようとすると、WMSの出荷実績、設備の稼働ログ、勤務実績、センサー値がそれぞれ別の場所に別の形式で存在していることに気づきます。
データがないのではありません。
データが分散しているのです。
このページは、2026年9月に公開した「物流データ基盤」シリーズ全9回を1ページにまとめたものです。集めたデータを、現場で使い続けられるデータに変えるために何を設計し、何を運用するのか。全体像と各回の要点を整理しています。
物流データ基盤とは何か
本シリーズでの定義
データ基盤とは、データを使える状態にするための仕組み
物流データ基盤とは「データを置く場所」ではなく、倉庫や物流現場で生まれるデータを分析・改善に使える状態にしておくための仕組みです。置き場所は、その仕組みの一部にすぎません。
新しいシステムを1つ導入すれば手に入るものではなく、既存のWMSや設備、人の運用を前提に設計するものです。
この定義から出てくる帰結は明確です。「どこに置くか」を先に決めても基盤は完成しません。決めるべきは、何を、誰が、どう使うのかです。
なぜ物流現場で必要になるのか
倉庫には、すでに多くのシステムが入っています。WMSは在庫と出荷を管理し、設備は稼働状況を記録し、ハンディ端末は作業の読み取りを残し、勤怠システムは誰がいつ働いたかを持っています。それぞれが、自分の目的に対しては正しく機能しています。
ところが、改善のために見たい数字は、たいてい複数のシステムにまたがります。人時生産性を出すには、作業量(WMS)と投入時間(勤怠)の両方が要ります。工程のボトルネックを特定するには、作業実績(ハンディ端末)と設備の停止(設備ログ)を突き合わせる必要があります。出荷遅延の原因を説明するには、その日の物量、工程ごとの所要時間、設備の状態、人員の配置を並べなければなりません。
つまり、WMSだけでは足りないという構造が最初からあります。業務システムは業務を回すために作られており、複数システムを横断して比較するようには設計されていないためです。物流データ基盤が必要になるのは、この「またがり」を毎回人手で埋めるのが現実的でなくなったときです。
基盤が担う4つの役割
データ基盤を1つの箱として捉えると、判断は「導入するか、しないか」に限られます。役割に分けると、いま何が欠けているのかが具体的に見えてきます。
→
→
加工
分析できる形に整える
単位・名称・時刻をそろえる
→
提供
必要な人・システムに渡す
使う側が受け取れる形にする
データ基盤が担う4つの役割
この4つは製品名でも部品名でもなく、役割の名前です。1つのツールが複数の役割を兼ねることもあり、1つの役割を複数の仕組みで分担することもあります。
そして4つは単純な並列ではなく、基本的にはデータが通っていく流れとして捉えることができます。連携が欠けていれば加工しようがなく、加工が欠けていれば提供しても使われません。下流の工夫だけでは、上流の欠けを恒常的に補うことはできません。
蓄積と加工の順序は、構成によって前後します
図では連携・蓄積・加工・提供の順に並べていますが、実際には取り込んだ後すぐ整えてから残す構成もあれば、生のまま残してから加工する構成もあります。
第7回で扱ったとおり、生ログ・整形済みデータ・KPI集計値を
それぞれ別に保持することも珍しくありません。
ここで押さえたいのは処理の並び順ではなく、4つの役割それぞれが担う仕事が欠けていないか、という点です。
基盤が整うと、答えられるようになること
データ基盤そのものは、目に見える成果を直接生みません。生まれるのは、これまで答えるのに半日かかっていた問いに、すぐ答えられる状態です。具体的には、次のような問いが対象になります。
出荷遅延の原因分析:なぜ昨日の出荷完了が遅れたのか。物量が多かったのか、特定の工程で滞留したのか、設備が停止していたのか。
工程別生産性の可視化:ピッキング、検品、梱包、出荷。どの工程に時間がかかっており、前週や前月と比べてどう変化しているのか。
ボトルネック工程の特定:全体の処理能力を決めているのはどの工程か。時間帯によってそれが変わるのか。
人員配置の見直し:どの時間帯に人が足りていないのか。応援を回すとすれば、どこからどこへか。
設備停止の影響評価:その停止が、実際に何件の出荷にどれだけ影響したのか。対策の優先順位をどう決めるか。
拠点間の比較:同じ作業を、拠点によってどれだけ違う時間で行っているのか。差はどこから来ているのか。
いずれも、単一のシステムの画面だけでは答えられません。複数のデータが同じ文脈で並んではじめて成立する問いです。基盤の価値は、ここにあります。
シリーズ全9回の内容
本シリーズは、基盤を「つなぐ・意味をそろえる・品質を保つ・処理する・蓄積する・使い続ける」という観点から、4部・全9回で構成しています。
第1部・なぜ基盤が必要か
第1回
「昨日の出荷が2時間遅れた原因」を説明しようとすると、必要な記録が4つのシステムに分かれて存在していることに気づきます。場所・単位・呼び方・確定タイミングの4つの断絶を整理し、Excelでの突き合わせが限界を迎えるタイミングを示します。
データがないのではない。データが分散している。
第2回
基盤を連携・蓄積・加工・提供の4つの役割に分解します。「設備のデータが分析に入っていない」は連携、「WMSと設備の数字が合わない」は加工——というように、現場で言われることを役割に対応させ、課題を切り分けられる形にします。
データ基盤とは「データを置く場所」ではなく、データを使える状態にするための仕組み。
第2部・つなぐ・整える
第3回
WMSはオーダー単位、設備は時刻や状態変化、人員は勤務単位。記録の刻み方が違うデータを、時刻・ID・ロケーション・イベントという共通軸で関連付けます。どの粒度で結合するかによって、見える改善が変わることを示します。
データを同じ場所に集めることと、同じ文脈で比較できるようにすることは、別の仕事。
第4回
マスタの「設計」ではなく「維持」に振り切った回です。コード変換テーブルの運用、名寄せの継続性、更新をいつの時点に適用するか、拠点ごとの独自運用の吸収、廃番・改番の扱いを整理します。
マスタは作った瞬間から古くなる。だから、整備の完了ではなく更新の継続を設計する。
第5回
データ品質を「収集時の技術問題」から「基盤の運用品質」へ切り替えます。欠損・遅延・異常値・マスタ不整合という4つの監視観点と、データが止まったことに気づく仕組み、誰が異常を受け取るかという運用設計を扱います。
データが間違っているとき、システムはたいてい正常に動いている。
第3部・処理する・蓄積する
第6回
取得頻度と処理タイミングは別の設計です。リアルタイム/準リアルタイム/日次/月次を「判断までの許容時間」で整理し、すべてを速くしようとすると何が起きるのかを示します。
1秒ごとに取得しても、日次処理ならリアルタイム分析にはならない。
第7回
生ログ・整形済みデータ・KPI集計値は、読む頻度も量も求められる速さも違います。データ量、保持期間、更新頻度、利用者、可用性、運用負荷、コストという7つの判断軸から保存先を導き、保持年数と費用の関係まで扱います。
「どこに置くか」を先に決めるのではなく、「何にどう使うか」から置き場所を決める。
第4部・使い続ける
第8回
稼働後に意識したい変化を「止まる・変わる・増える」の3つに整理します。とくに「変わる」は、止まるのではなく間違ったまま動き続けるため気づきにくい。監視・変更対応・コスト設計を運用視点で扱います。
作ることのゴールは「動くこと」。使い続けることのゴールは「変化に対応できること」。
第9回(最終回)
現場→取得→連携→蓄積→加工→KPI→分析→意思決定→人員配置・工程改善を一本の線としてつなぎます。基盤の完成を待ってから使い始めるのではなく、使いたいことを1つ決めて必要な範囲を細く通す、という進め方を示します。
データ基盤の目的は、データ基盤を作ることではない。データを意思決定に使える状態にすること。
課題別・どこから読めばよいか
現場で言われていることから、関係する役割と該当の回を引けるようにしています。
| 現場で言われること |
主に関わる役割・論点 |
参照する回 |
| データはあるが、分析が始められない |
全体 |
第1回・第2回 |
| 設備のデータが分析に入っていない |
連携 |
第2回 |
| WMSと設備の数字が合わない |
加工 |
第3回 |
| 一部の商品や拠点が集計に出てこない |
加工・マスタ |
第4回 |
| ダッシュボードの数字が正しいか自信がない |
品質 |
第5回 |
| リアルタイムにすべきか判断できない |
処理・提供 |
第6回 |
| データ量とコストが増え続けている |
蓄積・運用 |
第7回・第8回 |
| 去年の同じ時期と比べられない |
蓄積 |
第7回 |
| 動いてはいるが、この先が心配 |
運用 |
第8回 |
| 何から手をつければよいか分からない |
全体 |
第9回 |
シリーズを通じて一貫していること
9回を通じて変わらなかったのは、技術から入らないという順序です。どの回でも、先に決めるのは「何のために、誰が、どう使うのか」でした。
結合の粒度は、答えたい問いから決める:「時間帯別に集計したら何か見えるか」ではなく、「どの時間帯に人が足りていないかを知りたい」から始めます(第3回)。
処理タイミングは、その数字で何をするかで決まる:技術的に速くできるかではなく、受け取った人がいつまでに動く必要があるかです(第6回)。
保存先は、用途の結果として決まる:「DWHを入れるべきか」には答えられません。答えられるのは「この用途のデータをどこに置くべきか」です(第7回)。
品質も基盤も、自動的には保証されない:仕組みは異常を見えるようにしますが、見て判断して対応するのは人です(第5回・第8回)。
集めただけのデータを、
現場で使い続けられるデータに変える。
よくある質問
データ基盤を作るには、大規模なシステム投資が必要ですか?
必ずしもそうではありません。まず必要なのは、どのデータを何と突き合わせたいのか、どの単位で比べたいのか、誰がその数字を見るのかという設計です。仕組みの規模は、その設計から決まります。実務的には、改善したいKPIを1つ決め、そこに必要なデータだけを対象に、連携から提供まで細く通してみる進め方が現実的です(
第2回・
第9回)。
データ収集の設計と、データ基盤の設計は何が違いますか?
収集は「何を、どう取るか」、基盤は「取れたものをどう使える状態にするか」です。たとえばセンサーをどう選ぶかは収集側の設計、すでに取得されてどこかに存在しているデータを引き取るのが基盤側の「連携」です。収集の設計については
物流データ収集シリーズのまとめページで整理しています。
まず基盤を整えてから、分析に取り組むべきでしょうか?
多くの場合、順序は逆になります。基盤の完成を待ってから使い始めると、何に使うかを決めずに作った仕組みが実際の用途と合わない、ということが起こりがちです。保存先も処理タイミングも、「何に使うか」が決まっていなければ判断できません(
第9回)。
データ品質を保つために、専任の監視担当者が必要ですか?
専任である必要はありません。必要なのは人員の増強ではなく役割の明示です。定期的な確認と、異常時の連絡先が決まっていれば、専任の監視担当者を置かずに運用できるケースもあります。まずは「止まったことに気づける」状態を作るところからです(
第5回・
第8回)。
拠点ごとにコードや運用が違うのですが、統一すべきでしょうか?
統一するか、変換して吸収するかの判断になります。既存の運用が定着している場合、現場の手順を変えるコストと、拠点ごとの変換ルールを維持し続けるコストを比べることになります。重要なのは違いをなくすことではなく、違いが記録に残っていることです(
第4回)。
物流データをめぐる、テーマの地図
倉庫のデータを現場改善につなげるまでには、いくつかの段階があります。本シリーズは、そのうち中間にあたる部分を扱っています。
STEP 1
収集
何を集めるか
どうやって集めるか
→
STEP 2 / 現在地
基盤
集めたものを
どう使える状態にするか
このページ
→
STEP 3
活用
使える状態になったデータを
何に使うか
今後のテーマ
点線:今後扱う予定のテーマ
この順序には意味があります。何を集めるかが決まっていなければ基盤は設計できず、使える状態になっていないデータは活用できません。一方で、すべてを順番に完成させてから次へ進む必要はありません。使いたいことを1つ決め、その範囲だけを収集から活用まで細く通してみる方が、実務では前に進みます。
関連:データ収集シリーズのまとめページ
本シリーズの前段にあたる「何を集めるか」「どうやって集めるか」は、8月に公開した2つのシリーズで扱っています。KPIからの逆算、収集項目・粒度・頻度の設計、識別技術、通信、データ形式、品質確保までを1ページに整理しています。
▶ 物流データ収集シリーズ 総まとめページはこちら
データ基盤は、判断が変わったときに価値になる
つなぎ、関連付け、意味をそろえ、品質を保ち、適切なタイミングで処理し、適切な場所に残し、変化に備える。これらが揃うと、冒頭の問いに答えられるようになります。「昨日の遅れの原因は、14時台の仕分けで設備が計12分停止したことです」。
そして答えが出るまでの時間が短くなれば、確認や振り返りを行いやすくなります。そこで判断と実行が繰り返されることで、改善のサイクルにつながります。
ただし、そこまでたどり着いても、まだ改善そのものではありません。数字を見て、シフトを組み替える、工程の順序を変える、応援を回す——現場で何かが変わったときに、はじめてデータは成果になります。
データ基盤の目的は、データ基盤を作ることではありません。
データを意思決定に使える状態にすることです。
ここまで来ると、次の問いが立ちます。では、物流現場ではこのデータを具体的に何に使えるのか? 使える状態になったデータを、どのKPIで見て、何を予測し、どんな判断に使うのか。この続きは、あらためて別のシリーズで扱います。
「まず何から通すか」の整理からご相談いただけます
変えたい現場の状態を1つ決めて、そこに必要なデータが今どこまで作れるのかを確認する——この最初の整理が、その後の進め方を決めます。全部を同時に整える必要はありません。どこから細く通すかを一緒に考えるところから始められます。
「何から始めればよいか分からない」という段階からでもご相談いただけます。
お問い合わせはこちら