
データは集まったのに、なぜ分析が始まらないのか?
—物流データ基盤が必要になる瞬間
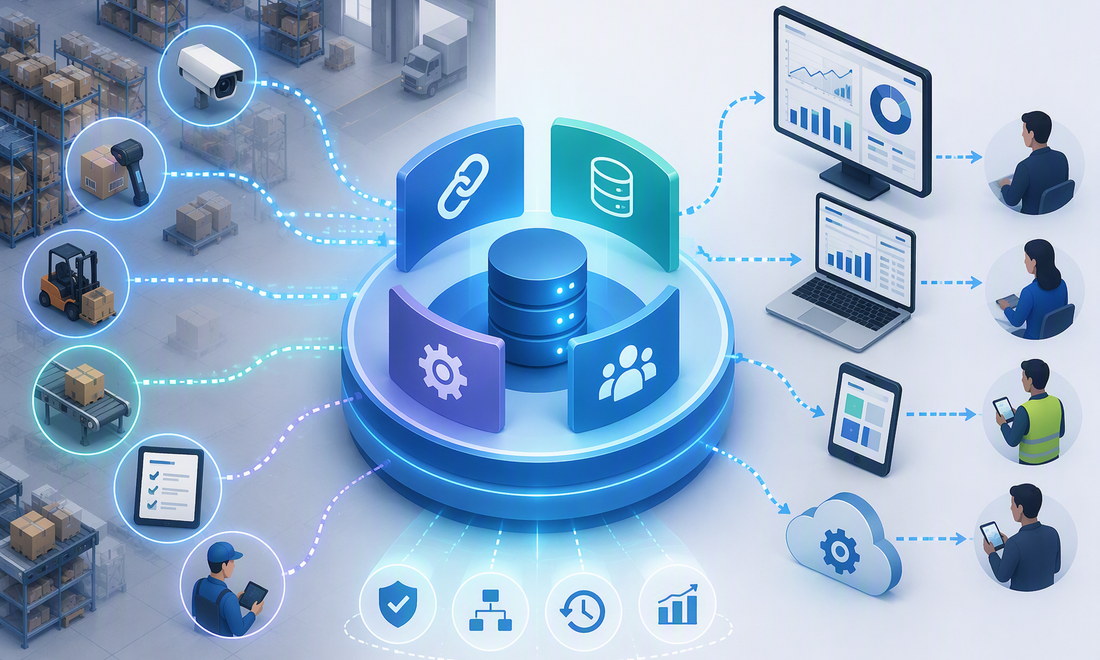
・データを集めた後に、多くの現場がぶつかる壁の正体
・「なぜ今日の出荷が遅れたのか」を説明するために何が足りないのか
・データを「使える状態」にするために、次に考えるべきこと
データ収集の設計を進めていくと、ある時期から現場の様子が変わります。ハンディ端末の読み取り記録が溜まり、設備の稼働ログが残り、WMSには日々の出荷実績が積み上がっていく。「データがない」という状態は、たしかに解消されています。
ところが、そこから分析がすぐに始まるとは限りません。むしろ、現場では次のような会話が起きがちです。
「昨日の出荷、予定より2時間遅れましたよね。原因は何でしたか」
「たぶん、午後のピッキングが詰まったのだと思います」
「それ、データで確認できますか」
「……確認はできると思います。ただ、いくつかシステムを見ないと分かりません」
データは集まっている。にもかかわらず、ひとつの問いに答えるのに時間がかかる。本シリーズは、この状態を出発点にします。
1. 「なぜ今日の出荷が遅れたのか」を説明してみる
具体的に考えてみます。ある日の出荷完了が、通常より2時間遅れました。その理由を説明するには、何を見る必要があるでしょうか。
ここまでは、ごく自然な調査手順です。問題は、これらのデータがそれぞれ別の場所に、別の形式で存在していることです。
| 見たいこと | どこにあるか | どんな形で残っているか |
|---|---|---|
| 出荷指示・実績 | WMS | オーダー単位。1件ごとに指示日時と完了日時が記録されている |
| 設備の稼働状況 | 設備メーカーの管理画面/制御装置 | 時間単位。1分ごと、あるいは秒単位の稼働・停止の記録 |
| 人員の勤務実績 | 勤怠システム/シフト表 | 1日単位、または勤務区分単位。出勤・退勤時刻 |
| 作業の進捗 | ハンディ端末のログ | 読み取りイベント単位。誰が・いつ・何を読んだか |
| 環境・入荷状況 | センサー/入荷受付の記録 | センサーは一定間隔の数値、入荷は紙またはExcel |
それぞれのデータは、単体では正しく記録されています。収集の設計に問題があるわけでもありません。それでも「昨日の遅れの原因」は、すぐには出てきません。
2. データはあるのに、つながらない
この状態を分解すると、いくつかの断絶が見えてきます。
場所が違う
WMSのデータはWMSの中に、設備のデータは設備メーカーの管理画面に、勤怠のデータは勤怠システムにあります。一度に並べて見る画面が存在しません。担当者はそれぞれの画面を開き、CSVを出力し、手元のExcelに貼り付けることになります。
単位が違う
WMSはオーダー単位で記録します。設備は時間単位です。勤怠は勤務単位です。「14時台にピッキングが遅れた」と言いたくても、オーダー単位の記録を時間帯に割り当て直す作業が必要になります。実際の運用では、この変換を毎回手作業で行っているケースもあります。
呼び方が違う
同じ商品が、WMSでは「A001」、設備側のデータでは「000001」、Excelの管理表では「商品A」と書かれている。同じ拠点が、システムによって「東京DC」「TKY」「東京第二センター」と表記されている。人間が見れば同じものだと分かりますが、突き合わせる作業は人が担うことになります。
タイミングが違う
WMSの実績は日次で確定します。設備のログはリアルタイムで流れています。勤怠は月末に締められます。「昨日のデータ」と言ったときに、どこまでが確定した数字なのかが揃っていません。
データが分散しているのです。
3. 「Excelで頑張る」が限界を迎えるとき
最初のうち、この分散はExcelで吸収できます。月に一度、数人が半日かけて各システムからデータを出力し、突き合わせて資料をつくる。これで一定の分析はできます。
この方法が限界を迎えるのは、たとえば次のようなタイミングです。
分析の手法を高度にしても、この状況は改善しません。入力するデータを揃える工程が人手のままである限り、分析にかけられる時間はほとんど残らないからです。実務では、分析そのものよりも「分析に使えるデータを用意する」工程に多くの労力がかかります。
4. 必要なのは、データを使える状態にする仕組み
ここまでの話を整理すると、必要なのは「データをもっと集めること」ではありません。すでに集まっているデータを、問いに答えられる状態にしておく仕組みです。
そのためには、データをつなぎ、意味をそろえ、必要な形に整え、蓄積し、品質を保ちながら、使える状態を維持していく必要があります。本シリーズは、この流れに沿って全9回で構成しています。
これらをその都度の手作業ではなく、決まった仕組みとして持つこと。それが本シリーズで扱う「物流データ基盤」です。
新しいシステムを1つ導入すれば手に入るものではなく、既存のWMSや設備、人の運用を前提に設計するものです。
注意したいのは、これが「大きなシステムを入れる」という話ではないことです。実際に必要なのは、どのデータを何と突き合わせたいのか、どの単位で比べたいのか、誰がその数字を見るのか——という設計です。仕組みの規模は、その設計から決まります。
5. 基盤があると、何が変わるのか
冒頭の問いに戻ります。「なぜ今日の出荷が遅れたのか」。
| 基盤がない場合 | 基盤がある場合 |
|---|---|
| 複数のシステムや管理画面を順に開く | 関連するデータをまとめて確認できる |
| CSVを出力してExcelで突き合わせる | あらかじめ関連付けた状態で利用できる |
| 担当者の手が空いたときに調べる | 必要なタイミングで確認できる状態になっている |
| 「たぶんピッキングだと思います」 | 「14時台の仕分けで、設備が計12分停止しています」 |
| 調査に半日かかるため、毎回はやらない | 毎日確認できるので、傾向が見える |
違いは、答えの精度だけではありません。調べるコストが下がることで、調べる回数が増えるという点が本質的です。月に一度しか振り返れなかったものが毎日確認できるようになると、改善のサイクルそのものが変わります。
6. データを集めた次にぶつかる壁
8月の2シリーズでは、データを集める側の設計を扱ってきました。何を集めるか、どの粒度で、どの頻度で。どう識別し、どう取得し、どう送り、どう前処理するか。
これらを丁寧に設計しても、集めたデータが複数のシステムに分かれて存在している限り、分析はすぐには始まりません。収集の設計と、分析の実行のあいだには、もうひとつの設計領域があります。
「データ活用のためにセンサーを入れた。ダッシュボードも導入した。それでも、現場の判断は変わらなかった」
この状況の背景には、集めたデータが分析可能な形に整っていないことがあります。足りていないのは、データでもツールでもなく、その間をつなぐ設計です。
本シリーズでは、この領域を9回に分けて扱います。次回は、データ基盤が担う役割を「連携・蓄積・加工・提供」の4つに分解し、自社の課題がどこにあるのかを切り分けられる形に整理します。
まとめ:分散したままでは、データは判断材料にならない
データを集めることに成功した現場が、次にぶつかるのは「集めたデータがつながらない」という壁です。WMSの実績、設備の稼働ログ、勤務実績、センサー値——それぞれは正しく記録されていても、場所も、単位も、呼び方も、確定タイミングも違います。
この状態では、ひとつの問いに答えるだけで半日かかります。そして、半日かかるものは日常的には行われません。データが判断を変えるところまで届かないとき、原因は分析そのものではなく、その手前にあります。
現場で使い続けられるデータに変える。
それが、物流データ基盤の役割です。
では、その「基盤」とは具体的に何をするものなのでしょうか。次回は、データ基盤を1つの箱として捉えるのをやめ、連携・蓄積・加工・提供という4つの役割に分けて整理します。自社で起きている問題が、どの役割の問題なのかを切り分けられるようになることがゴールです。
WMS・設備・勤怠・センサーと、データの出どころが分かれたまま止まっている——という段階からのご相談を承っています。どのデータを何と関連付けたいのか、どの単位で比べたいのかという整理からご一緒できます。
「データはあるが、つながっていない」という状態からでもご相談いただけます。
お問い合わせはこちら