
基盤の完成がゴールではない
—データが現場改善に変わるまでの一本の線
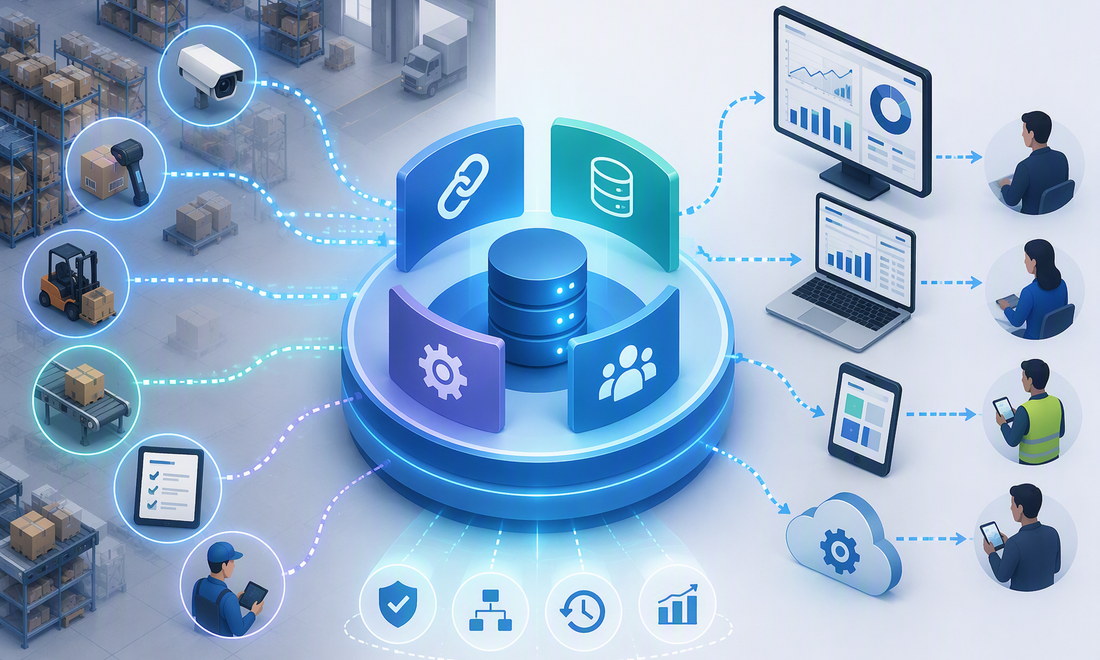
・現場のデータが改善アクションに至るまでの流れの全体像
・シリーズ全9回で扱った内容が、どこに位置していたのか
・データ基盤を作ることと、データを使うことの関係
シリーズの第1回で、こんな場面から始めました。「昨日の出荷、予定より2時間遅れましたよね。原因は何でしたか」——データはあるのに、答えるのに半日かかる。
ここまでの8回で扱ってきたのは、この問いに答えられる状態をどう作るかでした。ただ、忘れてはいけないことがあります。
1. 現場から改善まで、一本の線でつなぐ
データが現場の改善に至るまでには、いくつもの段階があります。シリーズで扱ってきたものを、順に並べてみます。
この線のどこかが切れていると、最後までたどり着きません。そして本シリーズが主に扱ってきたのは、この線の「連携」から「提供」までです。
地味な領域です。しかし、ここが崩れていると後続がすべて成立しません。突き合わせられないデータからは比較できるKPIが作れず、信用されない数字では判断が変わりません。
2. シリーズ全9回のふりかえり
本シリーズで扱った内容を、あらためて整理します。
| 第1回 | データは集まったのに、なぜ分析が始まらないのか? | データがないのではなく、分散している |
| 第2回 | 物流データ基盤は「箱」ではなく「4つの役割」 | 連携・蓄積・加工・提供に分けて考える |
| 第3回 | WMSと設備データは、なぜそのままでは比較できないのか? | 共通軸を決め、結合粒度を問いから逆算する |
| 第4回 | 「A001」と「000001」が同じ商品だと、誰が保証するのか? | マスタは作った瞬間から古くなる |
| 第5回 | 昨日まで正しかったデータが、今日から間違っている | 品質は自動的には保証されない |
| 第6回 | アラートは1分以内、生産性は翌朝でいい | 処理タイミングは用途から決める |
| 第7回 | 物流データはどこに置けばいいのか? | 置き場所は用途の結果として決まる |
| 第8回 | データ基盤は作った日が一番動く | 止まる・変わる・増えるに備える |
| 第9回 | 基盤の完成がゴールではない(本記事) | データを意思決定に使える状態にする |
9回を通じて一貫していたのは、技術から入らないという順序です。どの回でも、先に決めるのは「何のために、誰が、どう使うのか」でした。
現場で使い続けられるデータに変える。
3. 基盤を作ることと、データを使うことの関係
ここで、シリーズを通じてもっとも誤解されやすい点を整理しておきます。
データ基盤の整備には時間がかかります。連携の設計、マスタの運用、品質の監視、処理タイミングの決定、保存先の判断。どれも一朝一夕には決まりません。そのため、こう考えたくなります。「まず基盤を整えてから、分析に取り組もう」。
しかし、基盤の完成を待ってから使い始めると、多くの場合その基盤は使われません。何に使うかを決めずに作った仕組みは、実際の用途と合わないためです。第7回で扱った保存先も、第6回の処理タイミングも、「何に使うか」が決まっていなければ判断できませんでした。
順序は逆です。使いたいことを1つ決め、そこに必要な範囲だけを通す。第2回で触れたとおり、細くても一度、連携から提供まで通っていれば、対象を広げるときの見通しが立ちます。
したがって進め方も、基盤を完成させてから使い始めるのではなく、使いたいことから必要な範囲を決め、使いながら広げていく形になります。
4. これから取り組む場合の出発点
シリーズ全体を踏まえて、最初にやることを整理します。
この順序であれば、投資を抑えながら、判断に直結するデータから整えていくことができます。
本シリーズで扱ってきた内容は、物流の業務知識だけでも、IT・通信の技術知識だけでも設計できません。どのKPIを改善したいかという業務側の理解と、データをどう関連付け・維持し・処理するかという技術側の理解の、両方が必要になります。
この領域は、システムを導入して終わりではなく、使い続けられる状態を設計するという性格を持っています。だからこそ、運用の話が繰り返し出てきました。
まとめ:基盤は、判断が変わったときに価値になる
9回にわたって、データを使える状態にするための要素を扱ってきました。つなぎ、関連付け、意味をそろえ、品質を保ち、適切なタイミングで処理し、適切な場所に残し、変化に備える。
これらが揃うと、冒頭の問いに答えられるようになります。「昨日の遅れの原因は、14時台の仕分けで設備が計12分停止したことです」。そして答えが出るまでの時間が短くなると、確認する回数が増えます。回数が増えると、改善のサイクルが回り始めます。
ただし、そこまでたどり着いても、まだ改善そのものではありません。数字を見て、シフトを組み替える、工程の順序を変える、応援を回す——現場で何かが変わったときに、はじめてデータは成果になります。
データを意思決定に使える状態にすることです。
そして、ここまで来ると次の問いが立ちます。では、物流現場ではこのデータを具体的に何に使えるのか? 使える状態になったデータを、どのKPIで見て、何を予測し、どんな判断に使うのか。この続きは、あらためて別のシリーズで扱いたいと考えています。
変えたい現場の状態を1つ決めて、そこに必要なデータが今どこまで作れるのかを確認する——この最初の整理が、その後の進め方を決めます。全部を同時に整える必要はありません。どこから細く通すかを一緒に考えるところから始められます。
「何から始めればよいか分からない」という段階からでもご相談いただけます。
お問い合わせはこちら